

Das Wichtigste in Kürze
- Auf dem OCP Global Summit am 12. Oktober wurde NVIDIAs aktualisiertes offenes Rack-Design MGX 1.2 für Installationen mit bis zu 250 kW pro Rack veröffentlicht, mit einer flüssigkeitsgekühlten 5.000-A-Stromschiene, so NVIDIA.
- Enverus Intelligence Research schätzt, dass eine 800-VDC-Verteilung die Elektro-Investitionskosten gegenüber 415 VAC um 13 % senkt, den Gesamtwirkungsgrad von 79,8 % auf 93,8 % steigert und bis zu 60 % weniger Kupfer pro MW benötigt.
- Nach unserer Berechnung bedeutet dieser Effizienzunterschied, dass von 1.000 bezogenen MW etwa 938 MW die IT-Ausrüstung erreichen, gegenüber heute etwa 798 MW, also rund 140 MW mehr Rechenleistung pro Gigawatt.
- Am 22. Juli 2026 schalteten nach einer Netzstörung rund 3.900 MW Rechenzentrumslast in PJM auf Notstrom um, das bisher größte Ereignis dieser Art und das 2,6-Fache des Ereignisses von 2024 (PJM-Zahlen, unsere Berechnung).
- Die FERC hat die NERC-Standards für Rechenlasten verbindlich gemacht. Sie müssen bis zum 31. Dezember 2026 bei der FERC eingereicht werden, und PJM plant im November eine eigene Einreichung zum Ride-Through, berichteten POWER und PJM.
Drei Jahre lang drehte sich die Kostenfrage in KI-Rechenzentren um Chips und Grundstücke. Diese Woche ist sie in San Jose in den Elektroraum gewandert. Auf dem Open Compute Project (OCP) Global Summit steuerte NVIDIA Rack- und Tray-Designs für Vera Rubin sowie eine MGX-1.2-Spezifikation bei, die bis zu 250 kW pro Rack reicht. NVIDIA, AMD, Google und Meta veröffentlichten einen gemeinsamen Bauplan für Rechenzentrumsanlagen. Google, Meta, Microsoft und NVIDIA veröffentlichten eine Spezifikation dafür, wie sich KI-Standorte verhalten sollen, wenn das Netz schwankt.
Das ist die Kosten- und Technologiegeschichte des Quartals. Racks mit 250 kW lassen sich mit der heutigen 415-VAC- und 54-V-Technik nicht wirtschaftlich versorgen, und das Netz kann Standorte, die bei einer Störung Gigawatt an Last abwerfen, nicht länger verkraften. Für beide Probleme gibt es jetzt eine Spezifikation, ein Preisschild und eine Frist.
Was sich diese Woche geändert hat: Das offene Rack erreicht 250 kW
Der OCP Global Summit fand vom 12. bis 15. Oktober im McEnery Convention Center in San Jose statt. In seinem Beitrag vom 12. Oktober erklärte NVIDIA, MGX 1.2 „unterstützt Rack-Installationen bis 250 kW“, ergänzt eine flüssigkeitsgekühlte 5.000-A-Stromschiene, Blind-Mate-Flüssigkeitskühlung auf Rack-Ebene, lüfterlose flüssigkeitsgekühlte Compute-Trays und native Unterstützung für 19-Zoll-Geräte. Eine separate Vera-CPU-Rack-Spezifikation überträgt dieselbe offene Architektur auf CPU-lastige agentische Workloads.
Zwei Dokumente zur Anlagenplanung sind für Bauherren wichtiger als das Rack selbst. Die Open Data Center Specification v0.7 von NVIDIA, AMD, Google und Meta legt einen gemeinsamen Bauplan für Stromarchitektur, Kühlung und räumliche Anordnung fest. Yahoo Finance berichtete, Ziel sei es, Systemherstellern, Colocation-Anbietern und Betreibern vordefinierte Vorlagen statt vieler unterschiedlicher Kundendesigns an die Hand zu geben. Die OCP Grid Resilience Specification von Google, Meta, Microsoft und NVIDIA legt fest, wie KI-Anlagen bei Netzstörungen am Netz bleiben und in weniger als zwei Sekunden wieder nahezu Volllast erreichen.
| Veröffentlicht auf dem OCP, 12. bis 13. Okt. 2026 | Was festgelegt wird | Unterstützer |
|---|---|---|
| MGX-1.2-Rack-Spezifikation | Racks bis 250 kW, flüssigkeitsgekühlte 5.000-A-Stromschiene, Blind-Mate-Flüssigkeitskühlung, 19-Zoll-Unterstützung | NVIDIA und OCP-Partner |
| Open Data Center Specification v0.7 | Anlagenbauplan für Stromarchitektur, Kühlung und Anordnung | NVIDIA, AMD, Google, Meta |
| OCP Grid Resilience Specification | Bei Netzstörungen am Netz bleiben, in unter zwei Sekunden wieder nahezu Volllast erreichen | Google, Meta, Microsoft, NVIDIA |
| Visionbay-K-1-Plattform | 800-VDC-Design für KI-Fabriken, schrittweise eingeführt statt komplett ab dem ersten Tag | Visionbay, mit Strom- und Wärmetechnik von Vertiv |
Quellen: NVIDIA, 12. Okt. 2026; HPCwire, 13. Okt. 2026. Die Open Data Center Specification ist ein Entwurf in Version 0.7. Es handelt sich um Designs und Standards, nicht um Auslieferungen.
Der Dichtesprung ist groß. Bei 250 kW ziehen vier Racks ein Megawatt (unsere Berechnung). Der DC-Market-Insights-Bericht Data Center Rack Power Distribution Unit Market beziffert heutige KI-Racks auf 60 kW bis 132 kW. Das Summit-Programm von Vertiv ging noch weiter, mit Sitzungen zu Racks mit 300 kW, 600 kW und Megawatt-Klasse sowie dazu, wie 800 VDC das Fehlerverhalten verändert, so Vertivs Veranstaltungsseite.
Was es kostet: Warum 800 VDC eine Frage von Investitionen und Kupfer ist
Die Physik ist einfach. Bei gleicher Leistung bedeutet höhere Spannung geringeren Strom, und geringerer Strom bedeutet dünnere Leiter und weniger Umwandlungsstufen. NVIDIAs eigener Technik-Blog schreibt, die Versorgung eines einzelnen 1-MW-Racks mit 54 VDC „erfordert bis zu 200 kg Kupfer-Stromschiene“. Nach NVIDIAs Angaben senkt 800 VDC den Kupferbedarf um 45 %, verbessert den Gesamtwirkungsgrad gegenüber 54-V-Systemen um bis zu 5 %, senkt die Wartungskosten um bis zu 70 % und die Gesamtbetriebskosten um bis zu 30 %.
Eine unabhängige Schätzung geht beim Wirkungsgrad noch weiter. Im Juni verglich Enverus Intelligence Research 800 VDC mit einem herkömmlichen 415-VAC-Design. Ergebnis: 13 % niedrigere Elektro-Investitionskosten, ein um 14 Prozentpunkte höherer Gesamtwirkungsgrad (93,8 % gegenüber 79,8 %) und bis zu 60 % weniger Kupfermasse pro MW. In Kombination mit DC-gekoppelter Solarenergie, Batterien und Brennstoffzellen hinter dem Zähler bezifferte Enverus den 10-Jahres-Wert auf 1,63 Mrd. $ pro 1-GW-Campus, davon 440 Mio. $ durch den Wegfall von AC-Umwandlungsverlusten.
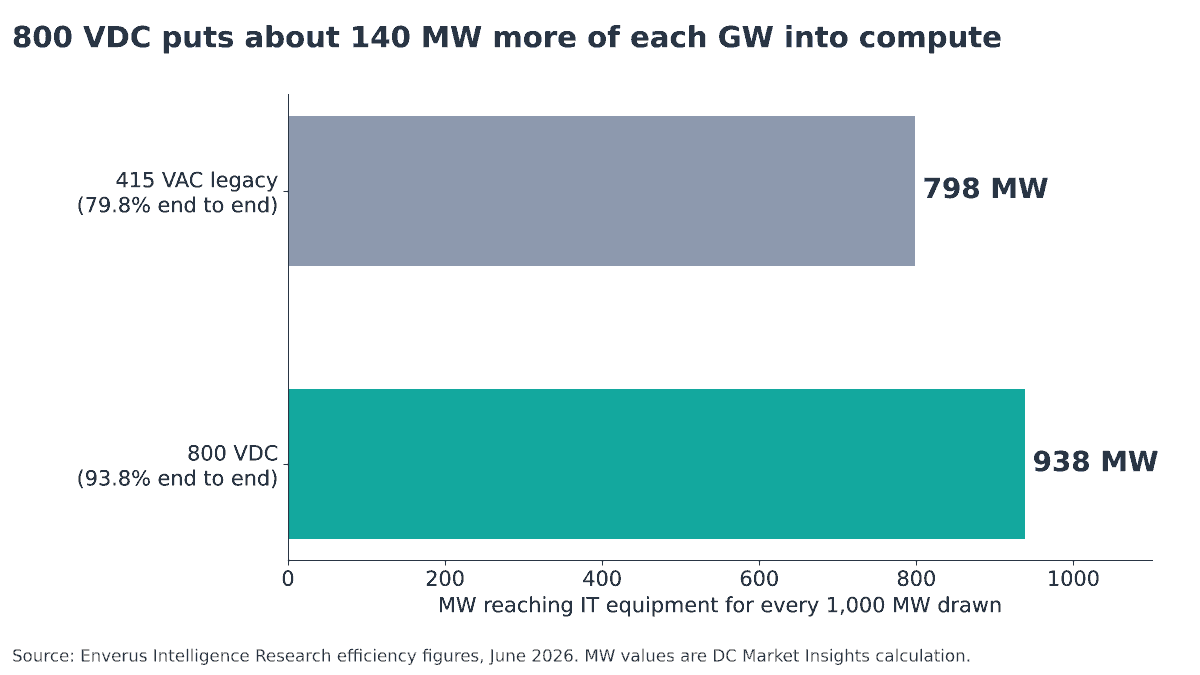
Nach unserer Berechnung bedeuten die Effizienzzahlen von Enverus, dass von jedem Gigawatt rund 140 MW mehr bei den Chips ankommen, also etwa 17,5 % mehr Rechenleistung aus demselben Netzanschluss. In einem Markt, in dem der Netzanschluss der knappste Produktionsfaktor ist, ist das die wichtigste Zahl. Vom Gesamtwert von 1,63 Mrd. $ machen die 440 Mio. $ aus Umwandlungsverlusten etwa 27 % aus (unsere Berechnung). Der Rest hängt von Entscheidungen zu Erzeugung und Speicherung vor Ort ab.
| Kennzahl, 800 VDC gegenüber heute | Wert | Quelle |
|---|---|---|
| Elektro-Investitionskosten gegenüber 415 VAC | 13 % niedriger | Enverus, Jun. 2026 |
| Gesamtwirkungsgrad | 79,8 % auf 93,8 % | Enverus, Jun. 2026 |
| Kupfermasse pro MW gegenüber 415 VAC | Bis zu 60 % niedriger | Enverus, Jun. 2026 |
| Kupferbedarf gegenüber 54 V im Rack | 45 % niedriger | NVIDIA, Mai 2025 |
| Wartungskosten | Bis zu 70 % niedriger | NVIDIA, Mai 2025 |
| Gesamtbetriebskosten | Bis zu 30 % niedriger | NVIDIA, Mai 2025 |
| 10-Jahres-Wert pro 1-GW-Campus, mit DC-gekoppelter Stromerzeugung vor Ort | 1,63 Mrd. $ | Enverus, Jun. 2026 |
Quellen: Enverus, 24. Jun. 2026; NVIDIA Technical Blog, 20. Mai 2025. Die beiden Quellen verwenden unterschiedliche Bezugsgrößen (415-VAC-Verteilung in der Anlage und 54-V-Verteilung im Rack) und sollten nicht direkt verglichen oder addiert werden. Die NVIDIA-Zahlen sind Herstellerangaben.
KI-Chips der nächsten Generation erzwingen ein Umdenken bei der Stromarchitektur von Rechenzentren.
Die Kupferpreise verstärken das Argument. LME-Kupfer wurde am 14. Oktober bei etwa 14.650 $ pro Tonne gehandelt, 17 % mehr als zu Jahresbeginn, nach einem Rekord von 14.875 $ am 10. September, und Aurubis hob seine europäische Prämie für 2027 auf den Rekordwert von 347 $ pro Tonne an, berichtete Reuters. Zu diesem Preis enthalten die 200 kg Stromschiene in NVIDIAs 1-MW-Beispiel Kupfer im Wert von etwa 2.930 $, und eine Reduzierung um 45 % spart rund 90 kg pro Rack (unsere Berechnung). Aus unserer Sicht ist die Metallrechnung der kleinere Teil. Größer sind die Kosten für Gewicht, Stellfläche sowie den Arbeitsaufwand für Installation und Wartung schwerer Niederspannungsleiter bei diesen Dichten.
Wie die Technologie den Bau verändert
800 VDC kommt nicht in einem Schritt. NVIDIA erklärte im August, dass mehr als 80 Gerätehersteller und Infrastrukturunternehmen nach seiner 800-VDC-Spezifikation entwickeln. Ein MGX-kompatibles 800-VDC-Power-Rack kommt in der zweiten Jahreshälfte 2026, und ein Row Power Center mit bis zu 2 MW pro Reihe wird 2027 erwartet. NVIDIA hat angekündigt, dass die Serienproduktion von 800-VDC-Rechenzentren 2027 mit seinen Kyber-Rack-Scale-Systemen zusammenfällt. Die K-1-Plattform von Visionbay, die auf dem OCP mit Vertiv-Technik gezeigt wurde, ist darauf ausgelegt, die 800-VDC-Verteilung schrittweise einzuführen, statt ab dem ersten Tag eine vollständige Umstellung zu verlangen.
Das verändert die elektrische Stückliste:
- Stromverteilung im Rack. Der DC-Market-Insights-Bericht zu Rack-PDUs schätzt den Wertanteil klassischer Rack-PDUs 2025 auf etwa 205.000 $ pro MW und erwartet, dass 800 VDC den PDU-Wert pro MW in KI-Racks senkt. Geräte mit mehr als 30 kW sind das am schnellsten wachsende Segment.
- Stromschienensysteme und Stromschienen. Überkopf-Stromschienensysteme kosten nach Schätzungen von DC Market Insights etwa 110.000 $ pro MW Whitespace. Bei 800 VDC sinkt der Strom und die Leiter werden kleiner, während die Stromschiene im Rack bei MGX 1.2 zu einem flüssigkeitsgekühlten 5.000-A-Bauteil wird.
- Umwandlung und Schutz. Die Wertschöpfung wandert vorgelagert in Halbleiter-Umwandlung, Sidecar-Power-Racks und DC-Fehlerschutz. Die OCP-Sitzung von Vertiv zu einer offenen Referenzarchitektur für einen DC Fault Manager zeigt, wie neu diese Ebene noch ist.
- Energiemanagement. NVIDIAs DSX MaxLPS verteilt Strom nach tatsächlichem Bedarf. In einer zuvor veröffentlichten Evaluierung bei Nscale in Island stieg die Zahl der verwalteten GPUs innerhalb desselben Budgets von 264,4 kW von 140 auf 192, berichtete Data Center Frontier. Das sind 37 % mehr GPUs bei gleicher Leistung (unsere Berechnung), in einer Testumgebung.
Aus unserer Sicht gehören Anbieter von DC-Umwandlung, Schutztechnik und flüssigkeitsgekühlter Stromhardware zu den Gewinnern dieses Wandels. Anbieter, deren Umsatz mit Niederspannungs-AC-Kupfer und der Zahl der Steckdosen pro MW skaliert, sehen in KI-Hallen langsameres Wachstum, selbst wenn die gesamte Megawattzahl steigt.
Die Netzseite: eine Störung, 3.900 MW
Der zweite Kostenblock liegt außerhalb des Zauns. Am 6. Oktober stellte das Reliability-Engineering-Team von PJM seinem Planning Committee drei Ereignisse vor, bei denen Rechenzentrumslast nach einer einzigen Netzstörung auf Notstromerzeugung umschaltete. Die PJM-Präsentation beziffert sie auf etwa 1.500 MW am 10. Juli 2024, etwa 1.800 MW am 17. Februar 2025 und etwa 3.900 MW am 22. Juli 2026, das bisher größte Ereignis. Im Juli wechselten zunächst rund 2.900 MW, eine Minute später folgten etwa 1.000 MW. Die Frequenz der Eastern Interconnection erreichte 60,092 Hz.
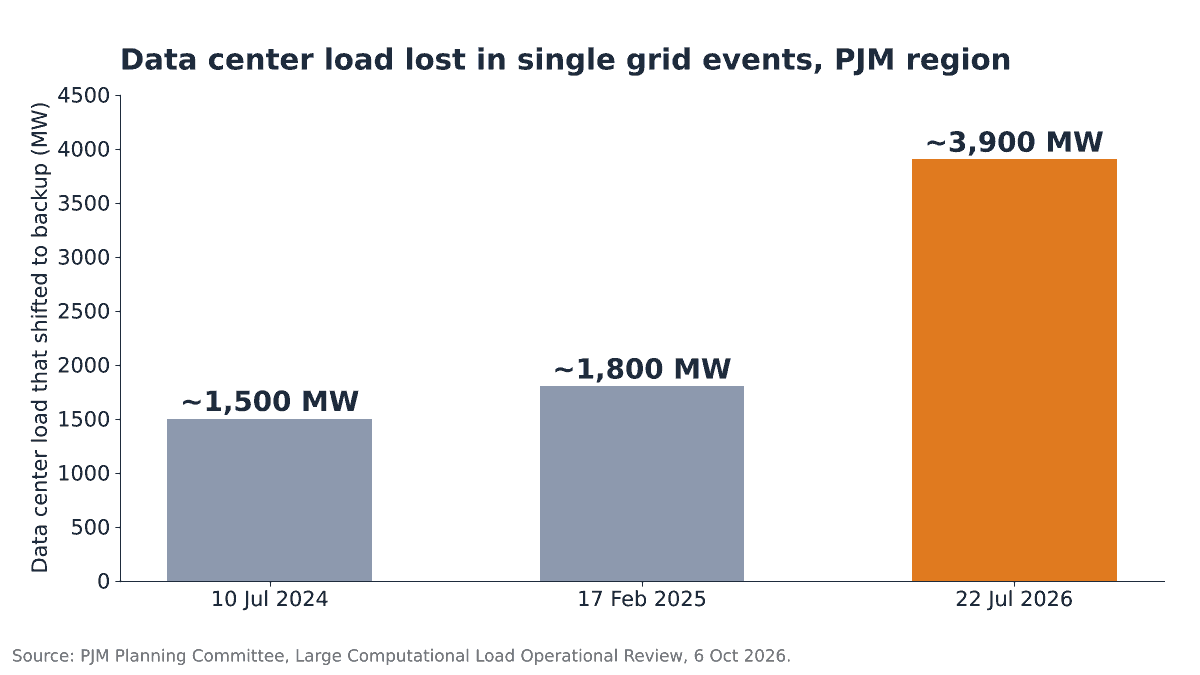
Die Last im Juli entsprach etwa 3 % der damaligen PJM-Nachfrage, und PJM meldete keine Auswirkungen auf die Zuverlässigkeit des Übertragungsnetzes, berichtete POWER. Die Untersuchung von 2024 zeigte, warum solche Ereignisse auftreten. Die gesamten 1,5 GW wurden durch kundenseitige Schutzeinrichtungen getrennt, und rund 1,26 GW blieben stundenlang vom Netz, weil ein Schutzkonzept die Anlagen nach drei Spannungseinbrüchen innerhalb einer Minute auf Notstrom hielt. POWER bezifferte den Wert für Juli 2026 auf mehr als 3 GW; die eigene Auswertung von PJM nennt etwa 3.900 MW, die wir hier verwenden.
Genau dieses Problem soll die Grid Resilience Specification lösen. Ian Buck von NVIDIA brachte es auf dem Summit auf den Punkt.
KI-Fabriken müssen Teil des Netzes sein, nicht nur Verbraucher, sondern auch Mitwirkende.
Das Regelwerk: Ride-Through wird zum Kostenposten
Die Regulierer bewegen sich im gleichen Zeitrahmen wie die Hardware. Die NERC gab am 4. Mai 2026 eine seltene Level-3-Warnung zu Rechenlasten heraus, mit Antworten bis zum 3. August, berichtete Utility Dive. Sie verlangt Inbetriebnahmetests bei Voll- und Nulllast sowie bei einer Spannungsänderung von mindestens 10 % und Störschreiber an den Standorten.
Die Unternehmen verfügten im Allgemeinen nicht über ausreichende Prozesse, Verfahren oder Methoden, um mit neu entstehenden Rechenlasten umzugehen.
Am 16. Juli wies die FERC die NERC an, verbindliche Zuverlässigkeitsstandards für Rechenlasten einzureichen, berichtete POWER. Alle fünf Kommissionsmitglieder stimmten für die Anordnung.
Dieser von der NERC vorgeschlagene Zeitplan ist nicht optional.
| Regel oder Schritt | Anforderung | Datum |
|---|---|---|
| NERC-Level-3-Warnung | Modellierungsdaten, Inbetriebnahmetests, Störschreiber für Rechenlasten | Herausgegeben am 4. Mai 2026, Antworten bis 3. Aug. 2026 |
| FERC-Anordnung, RD26-7-000 | Verbindliche NERC-Standards für Rechenlasten | Angeordnet am 16. Jul. 2026, fällig am 31. Dez. 2026 |
| PJM-Entwurf Ride-Through, Spannung | ERCOT-Spannungs-Ride-Through als Mindeststandard, für die gesamte Dauer glaubwürdiger Störungen | PJM-Einreichung bei der FERC für Nov. 2026 geplant |
| PJM-Entwurf Ride-Through, Wiederherstellung | Leistung nach der Störung zurück auf mindestens 90 % des Verbrauchs vor der Störung | PJM-Einreichung bei der FERC für Nov. 2026 geplant |
| PJM-Entwurf, bestehende Standorte | Müssen die Vorgaben erfüllen, sofern keine technischen Grenzen dokumentiert sind | PJM-Einreichung bei der FERC für Nov. 2026 geplant |
| NERC Phase II | Informatorische Einreichung zu weiteren Standards | 1. März 2027 |
Quellen: PJM, 6. Okt. 2026; POWER, 16. Jul. 2026; Utility Dive, 5. Mai 2026. Die PJM-Anforderungen sind Entwürfe der Large Load Working Group und können sich noch ändern.
Aus unserer Sicht ist die Klausel zu bestehenden Standorten die teure. Ein neuer Campus kann USV-Einstellungen, Schutzkonzepte und Steuerungen von Anfang an auf einen Ride-Through-Standard auslegen. Eine bestehende Halle in Nord-Virginia braucht unter Umständen Schutzstudien, Firmware- und Steuerungsänderungen und in manchen Fällen neue Hardware, um eine 90-%-Wiederherstellungsregel zu erfüllen, für die sie nie gebaut wurde.
Das größere Bild: Die Baukosten steigen weiter
All das trifft auf eine Kostenbasis, die ohnehin steigt. Der jüngste Rechenzentrums-Kostenindex von Turner & Townsend ergab, dass die Baukosten klassischer Anlagen 2025 in 52 Märkten im Schnitt um 5,5 % gestiegen sind, und einen Bauaufschlag von 7 % bis 10 % für KI-Rechenzentren in den USA gegenüber klassischen Anlagen mit ähnlicher IT-Kapazität. Tokio lag mit 15,2 $ pro Watt an der Spitze, gefolgt von Singapur mit 14,5 $ und Zürich mit 14,2 $, Silicon Valley kam auf 13,3 $. Nach unserer Berechnung kostet eine 100-MW-Halle zum Satz des Silicon Valley etwa 1,33 Mrd. $, und der KI-Aufschlag kommt mit rund 93 Mio. $ bis 133 Mio. $ hinzu.
Die Verfügbarkeit von Strom bleibt ein entscheidendes Hindernis, wobei lange Vorlaufzeiten für den Netzanschluss die wichtigste Einschränkung sind.
Standardisierte Designs sind die Antwort der Branche auf diesen Druck. Meta erklärte, sein Prometheus-Cluster in New Albany, Ohio, liege 2026 bei rund 1 GW, und Hyperion wachse in Richtung 5 GW, schrieb Meta Engineering. Data Center Frontier berichtete, dass einige Prometheus-Anlagen dank vereinfachter Strom- und Kühltechnik in etwa drei bis fünf Monaten betriebsbereit waren. Aus unserer Sicht ist eine offene Anlagenvorlage für Colocation-Anbieter mehr wert als jede einzelne Rack-Spezifikation, weil sie damit eine Halle bauen können, die mehrere Hyperscale-Mieter akzeptieren.
Was das für Betreiber, Investoren und Anbieter bedeutet
Unsere Einschätzung auf Grundlage der oben genannten Spezifikationen und Einreichungen:
- Neue Hallen jetzt für 800 VDC planen, auch wenn sie anfangs mit AC laufen. Platz für Sidecar-Power-Racks, DC-Stromschienentrassen und DC-Schutz kostet in der Planungsphase wenig. Eine spätere Nachrüstung in einer Halle, die für 132-kW-Racks gebaut wurde, kostet weit mehr.
- Den Netzanschluss in Rechenleistung bewerten, nicht in Megawatt. Nach den Enverus-Zahlen liefert derselbe 1-GW-Anschluss mit 800 VDC rund 140 MW mehr an die IT (unsere Berechnung). Diese Differenz gehört in jedes Modell für Strombezug und Standortbewertung.
- Ride-Through für bestehende Standorte budgetieren. Der PJM-Entwurf würde für bestehende Hallen gelten, sofern keine technischen Grenzen dokumentiert sind. Eigentümer von Kapazitäten in Nord-Virginia sollten vor der Einreichung im November mit Studien zu Schutz- und USV-Einstellungen beginnen.
- Anbieter: der Wertschöpfung vorgelagert folgen. Der Wertanteil pro MW verlagert sich von Niederspannungs-AC-Verteilung und Steckdosen hin zu Halbleiter-Umwandlung, DC-Schutz und flüssigkeitsgekühlten Stromschienen.
- Einsparversprechen von Herstellern als Spannen behandeln. NVIDIAs Angaben von 30 % bei den Gesamtbetriebskosten und 70 % bei der Wartung sind eigene Angaben. Die Enverus-Schätzung von 13 % bei den Investitionskosten ist die vorsichtigere Planungsgröße.
- Kupfer als Terminrisiko betrachten, nicht nur als Preisfrage. Bei LME-Kupfer um 14.650 $ pro Tonne und Rekordprämien für 2027 verringern Designs, die den Kupferbedarf um 45 % bis 60 % senken, auch das Risiko von Lieferverzögerungen.
Zur Marktgröße beim Wandel zur Gleichstromversorgung siehe unseren Bericht Data Center High-Voltage Direct Current (HVDC) Market, der den Markt 2025 auf 388,20 Mio. USD bewertet und bis 2035 6,27 Mrd. USD prognostiziert. Zur Stromhardware auf Rack-Ebene siehe den Bericht Data Center Rack Power Distribution Unit Market. Zur Überkopf-Stromverteilung siehe den Bericht Data Center Busway Market. Regeln zu Netzanschluss und Großlasten verfolgen wir in unserem Tracker zu Strom und Regulierung für Rechenzentren in den Vereinigten Staaten, die installierte Kapazität auf der Seite Rechenzentrumskapazität in den Vereinigten Staaten.
Worauf als Nächstes zu achten ist
- 21. Oktober 2026: Keynote der NVIDIA GTC Berlin, der nächste Termin für Neuigkeiten zu Vera Rubin und zum Einsatz von 800 VDC.
- November 2026: Zieltermin von PJM für die Einreichung seiner Antwort zum Ride-Through von Großlasten bei der FERC im Verfahren EL26-67-000.
- 5. Dezember 2026: Abstimmung des NERC Board über die Standards für Rechenlasten erwartet.
- Dezember 2026: Das NERC-Papier „Large Load Disturbance Performance“ wird erwartet.
- 31. Dezember 2026: NERC-Standards und Änderungen der Rules of Procedure sind unter RD26-7-000 bei der FERC fällig.
- 1. März 2027: Informatorische Einreichung der NERC zu Phase II fällig.
- 2027: NVIDIAs 2-MW-Row-Power-Center und Kyber-Rack-Scale-Systeme, der Zeitpunkt, ab dem NVIDIA die Serienproduktion von 800 VDC erwartet.
Häufig gestellte Fragen
Wie viel Leistung unterstützt das neue offene KI-Rack-Design?
Bis zu 250 kW pro Rack. NVIDIAs MGX-1.2-Spezifikation, veröffentlicht auf dem OCP Global Summit am 12. Oktober 2026, ergänzt eine flüssigkeitsgekühlte 5.000-A-Stromschiene und lüfterlose flüssigkeitsgekühlte Compute-Trays. Bei dieser Dichte ziehen vier Racks ein Megawatt.
Wie viel spart 800 VDC im Vergleich zu heutigen Stromdesigns?
Enverus schätzt gegenüber 415 VAC 13 % niedrigere Elektro-Investitionskosten, einen Wirkungsgrad von 93,8 % statt 79,8 % und bis zu 60 % weniger Kupfer pro MW. NVIDIA gibt gegenüber 54-V-Systemen im Rack 45 % weniger Kupfer, bis zu 70 % niedrigere Wartungskosten und bis zu 30 % niedrigere Gesamtbetriebskosten an. Beide verwenden unterschiedliche Bezugsgrößen.
Warum werfen Rechenzentren bei Netzstörungen Last ab?
Kundenseitige Schutzeinrichtungen schalten den Standort bei Spannungseinbrüchen auf Notstrom um. In PJM ist das seit 2024 dreimal geschehen, das größte Ereignis mit etwa 3.900 MW am 22. Juli 2026. Die NERC stellte fest, dass das Ereignis von 2024 vollständig durch kundenseitige Schutzeinrichtungen verursacht wurde, nicht durch Anlagen des Versorgers.
Ab wann gelten die neuen Ride-Through-Regeln?
Die NERC muss die verbindlichen Standards bis zum 31. Dezember 2026 bei der FERC einreichen, nach einer für den 5. Dezember erwarteten Abstimmung des Board. PJM plant eine eigene Einreichung im November 2026, und sein Entwurf würde bestehende Standorte erfassen, sofern keine technischen Grenzen dokumentiert sind.
Quellen
- NVIDIA, “OCP Global Summit: Amid Ecosystem Adoption, NVIDIA Opens Vera Rubin Architecture to Help Scale AI Factories Worldwide”, 12. Okt. 2026. Link
- PJM Planning Committee, “Large Computational Load (LCL) Operational Review”, 6. Okt. 2026. Link
- NVIDIA, “Why Scaling AI Compute Performance Requires a New Power Architecture”, 11. Aug. 2026. Link
- NVIDIA Technical Blog, “NVIDIA 800 VDC Architecture Will Power the Next Generation of AI Factories”, 20. Mai 2025. Link
- Enverus, “800 VDC rewrites AI data center power economics”, 24. Jun. 2026. Link
- Vertiv, “OCP Global Summit 2026”, Okt. 2026. Link
- Meta Engineering, “OCP Summit 2026: Powering AI with Open Innovations in Scale-Up, Scale-Out, and Scale-Across Networks”, 12. Okt. 2026. Link
- Turner & Townsend, “AI data center rush raises alarm over construction supply chain”, 5. Nov. 2025. Link
- POWER magazine, “FERC Orders Mandatory NERC Reliability Standards for Data Center and Other Computational Loads”, 16. Jul. 2026. Link
- POWER magazine, “3 GW Off PJM, Again: What NERC’s 2024 Investigation Already Told Us”, 10. Aug. 2026. Link
- Utility Dive, “NERC issues Level 3 alert, mandates action to address data center load losses”, 5. Mai 2026. Link
- Data Center Frontier, “OCP 2026: Agentic AI Drives the Data Center’s Chip-to-Grid Transformation”, 13. Okt. 2026. Link
- Reuters via Kitco News, “Aurubis raises 2027 European copper premium to record $347 a ton, sources say”, 14. Okt. 2026. Link
- Yahoo Finance, “Nvidia, AMD, Google, and Meta team up on global blueprint for data center design”, 12. Okt. 2026. Link
- HPCwire, “NVIDIA Details Open Designs for AI Power, Cooling and Networking”, 13. Okt. 2026. Link