

要点
- NVIDIAによると、10月12日のOCP Global Summitで、ラックあたり最大250 kWの導入に対応するオープンラック設計MGX 1.2の改訂版が公開された。液冷式の5,000 Aバスバーを備える。
- Enverus Intelligence Researchの推計では、800 VDC配電は415 VACと比べて電気設備の設備投資を13%削減し、エンドツーエンド効率を79.8%から93.8%に引き上げ、MWあたりの銅使用量を最大60%減らす。
- 当社試算では、この効率差により、受電1,000 MWあたりIT機器に届く電力は現状の約798 MWに対して約938 MWとなり、ギガワットあたり約140 MW多くの演算能力を確保できる。
- 2026年7月22日、PJM管内で系統障害を受けて約3,900 MWのデータセンター負荷がバックアップ電源に切り替わった。これまでで最大の事象であり、2024年の事象の2.6倍にあたる(PJMの数値、当社試算)。
- FERCはNERCの演算負荷に関する基準を義務化した。基準は2026年12月31日までにFERCへ提出される予定であり、PJMは11月に独自のライドスルー要件を申請する計画だとPOWERとPJMが報じている。
過去3年間、AIデータセンターのコストをめぐる議論は半導体と用地が中心であった。今週サンノゼで、その焦点は電気室へと移った。Open Compute Project(OCP)Global Summitにおいて、NVIDIAはVera Rubinのラックおよびトレイ設計と、ラックあたり250 kWに対応するMGX 1.2仕様を提供した。NVIDIA、AMD、Google、Metaは共通の施設設計図を公開した。Google、Meta、Microsoft、NVIDIAは、系統が揺らいだ際にAIサイトがどう振る舞うべきかを定める仕様を公開した。
これが今四半期のコストと技術をめぐる最大のテーマである。250 kWのラックに現行の415 VACと54 Vの機器で経済的に給電することはできず、障害時にギガワット級の負荷を脱落させるサイトを系統はもはや吸収できない。いずれの課題にも、今や仕様、価格、期限が揃っている。
今週の変化 オープンラックが250 kWに到達
OCP Global Summitは10月12日から15日まで、サンノゼのMcEnery Convention Centerで開催された。NVIDIAは10月12日の投稿で、MGX 1.2は「最大250kWのラック導入をサポートする」とし、液冷式5,000 Aバスバー、ラックスケールのブラインドメイト液冷、ファンレスの液冷コンピュートトレイ、19インチ機器のネイティブ対応を追加したと述べた。別途公開されたVera CPUラック仕様は、同じオープンアーキテクチャをCPU負荷の高いエージェント型ワークロードに拡張するものである。
建設事業者にとっては、ラックそのものよりも2つの施設関連文書の方が重要である。NVIDIA、AMD、Google、MetaによるOpen Data Center Specification v0.7は、電力アーキテクチャ、冷却、物理レイアウトの共通設計図を定める。Yahoo Financeの報道によれば、その狙いは、顧客ごとに異なる多数の設計ではなく、事前に定義されたテンプレートをシステムメーカー、コロケーション事業者、運用事業者に提供することにある。Google、Meta、Microsoft、NVIDIAによるOCP Grid Resilience Specificationは、AI施設が系統擾乱の間も接続を維持し、2秒未満でほぼ全負荷に復帰する方法を定める。
| OCPで公開(2026年10月12日から13日) | 定める内容 | 推進企業 |
|---|---|---|
| MGX 1.2ラック仕様 | 最大250 kWのラック、液冷式5,000 Aバスバー、ブラインドメイト液冷、19インチ対応 | NVIDIAおよびOCPパートナー |
| Open Data Center Specification v0.7 | 電力アーキテクチャ、冷却、レイアウトに関する施設設計図 | NVIDIA、AMD、Google、Meta |
| OCP Grid Resilience Specification | 系統擾乱時も接続を維持し、2秒未満でほぼ全負荷に復帰 | Google、Meta、Microsoft、NVIDIA |
| Visionbay K-1プラットフォーム | 初日から一括ではなく段階的に導入する800 VDC AIファクトリー設計 | Visionbay(Vertivの電力・熱管理技術を採用) |
出典:NVIDIA、2026年10月12日、HPCwire、2026年10月13日。Open Data Center Specificationはv0.7の草案である。これらは設計と標準であり、出荷実績ではない。
密度の向上幅は大きい。250 kWであれば、4ラックで1メガワットを消費する(当社試算)。DC Market InsightsのData Center Rack Power Distribution Unit Marketレポートは、現行のAIラックを60 kWから132 kWとしている。Vertivのイベントページによれば、同社のサミットプログラムはさらに踏み込み、300 kW、600 kW、MW級ラックや、800 VDCが障害時の挙動をどう変えるかに関するセッションを設けた。
コストの実像 800 VDCが設備投資と銅の問題である理由
物理の原理は単純である。電力が一定であれば、電圧が高いほど電流は小さくなり、電流が小さいほど導体は細く、変換段数は少なくて済む。NVIDIA自身の技術ブログは、1 MWのラック1台に54 VDCで給電するには「最大200 kgの銅バスバーが必要」だとしている。同社は、800 VDCにより銅の必要量が45%減り、54 Vシステムと比べてエンドツーエンド効率が最大5%向上し、保守コストが最大70%、総所有コストが最大30%削減されると主張する。
独立系の推計は、効率面でさらに大きな効果を示す。6月、Enverus Intelligence Researchは800 VDCを従来型の415 VAC設計と比較した。その結果、電気設備の設備投資は13%低く、エンドツーエンド効率は14ポイント高く(93.8%対79.8%)、MWあたりの銅質量は最大60%少なかった。DC結合のビハインド・ザ・メーター型太陽光、蓄電池、燃料電池と組み合わせた場合、1 GWのキャンパスあたり10年間の価値は16.3億ドルとなり、そのうち4.4億ドルはAC変換損失の解消によるものだとした。
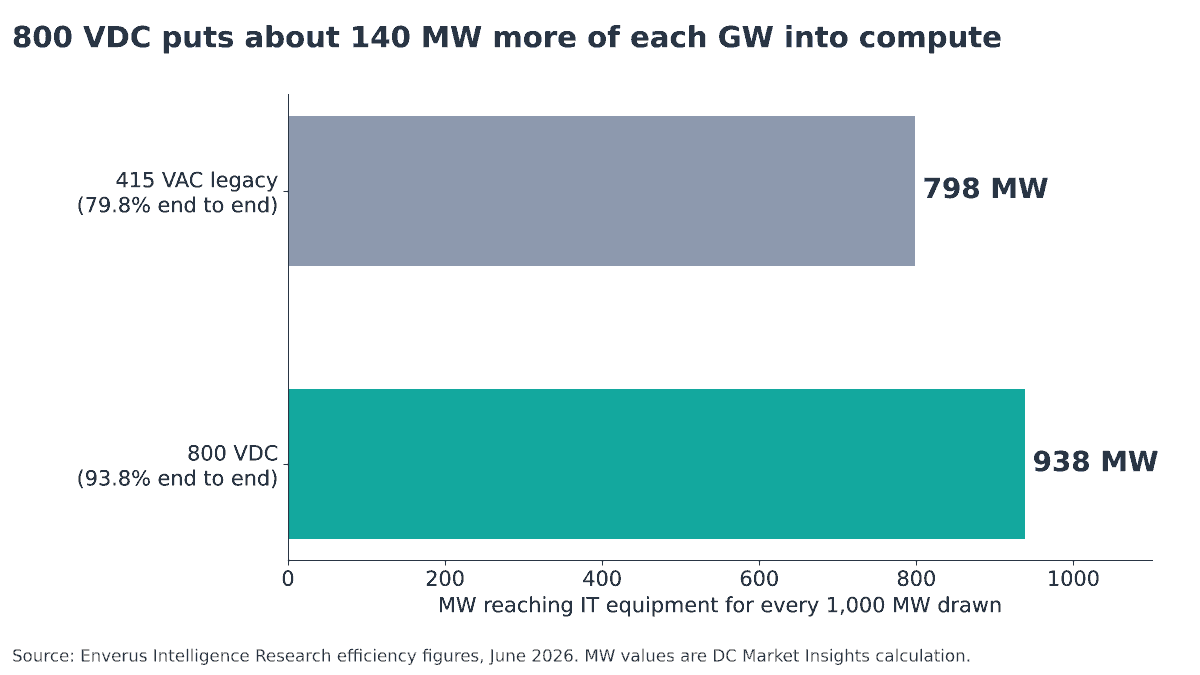
当社試算では、Enverusの効率データは、1ギガワットのうち約140 MW多くの電力がチップに届くことを意味し、同じ系統接続から約17.5%多くの演算能力を得られる計算になる。系統接続が最も希少な投入資源となっている市場において、これこそが最も重要な数字である。16.3億ドルの価値のうち、変換損失による4.4億ドルは約27%にあたる(当社試算)。残りはオンサイト発電と蓄電の選択に左右される。
| 指標(800 VDCと現行方式の比較) | 値 | 出典 |
|---|---|---|
| 415 VACと比べた電気設備の設備投資 | 13%低い | Enverus、2026年6月 |
| エンドツーエンド効率 | 79.8%から93.8%へ | Enverus、2026年6月 |
| 415 VACと比べたMWあたりの銅質量 | 最大60%少ない | Enverus、2026年6月 |
| ラック内54 Vと比べた銅の必要量 | 45%少ない | NVIDIA、2025年5月 |
| 保守コスト | 最大70%低い | NVIDIA、2025年5月 |
| 総所有コスト | 最大30%低い | NVIDIA、2025年5月 |
| DC結合オンサイト電源を備えた1 GWキャンパスあたりの10年間の価値 | 16.3億ドル | Enverus、2026年6月 |
出典:Enverus、2026年6月24日、NVIDIA Technical Blog、2025年5月20日。両出典は基準が異なる(施設配電の415 VACとラック内配電の54 V)ため、直接比較や合算はできない。NVIDIAの数値はベンダーの主張である。
次世代AIチップは、データセンターの電力アーキテクチャの再考を迫っている。
銅価格はこの論拠をさらに強める。Reutersの報道によれば、LME銅は9月10日に過去最高の1トンあたり14,875ドルを付けた後、10月14日には約14,650ドルで取引され、年初来17%上昇した。Aurubisは2027年の欧州向けプレミアムを過去最高の1トンあたり347ドルに引き上げた。この価格では、NVIDIAの1 MWの例にある200 kgのバスバーには約2,930ドル相当の銅地金が含まれ、45%削減すればラックあたり約90 kgを節約できる(当社試算)。当社の見方では、金属代は小さな部分にすぎない。より大きなコストは、この密度で重い低電圧導体を設置・保守するための重量、床面積、人件費である。
技術が建設をどう変えるか
800 VDCは一足飛びには到来しない。NVIDIAは8月に、80社を超える機器メーカーとインフラ企業が同社の800 VDC仕様に準拠した製品を開発していると述べた。MGX互換の800 VDC電源ラックは2026年下半期に登場し、列あたり最大2 MWに対応するロウ電源センターは2027年に見込まれる。NVIDIAは、800 VDCデータセンターの本格量産は2027年のKyberラックスケールシステムと時期を同じくするとしている。Vertivの技術を用いてOCPで披露されたVisionbayのK-1プラットフォームは、初日に全面切り替えを求めるのではなく、800 VDC配電を段階的に導入できるよう設計されている。
これにより電気設備の部材構成が変わる。
- ラック配電。DC Market Insightsのラック用PDUレポートは、2025年の従来型ラックPDUの搭載額をMWあたり約205,000ドルと推計し、800 VDCによってAIラックにおけるMWあたりのPDU価値が減少すると見込む。30 kW超の定格製品が最も成長の速いセグメントである。
- バスウェイとバスバー。DC Market Insightsの推計では、天井バスウェイはホワイトスペースのMWあたり約110,000ドルである。800 VDCでは電流が下がって導体が細くなる一方、ラック内のバスバーはMGX 1.2で液冷式の5,000 A部品となる。
- 変換と保護。価値はソリッドステート変換、サイドカー電源ラック、DC障害保護といった上流へ移る。オープンなDC Fault Managerリファレンスアーキテクチャに関するVertivのOCPセッションは、この領域がいかに新しいかを示している。
- 電力管理。NVIDIAのDSX MaxLPSは実需に応じて電力を配分する。Data Center Frontierの報道によれば、アイスランドのNscaleで以前公表された評価では、同じ264.4 kWの電力枠内で管理対象GPUが140基から192基に増えた。これは同じ電力で37%多いGPUにあたる(当社試算)が、試験環境での結果である。
当社の見方では、この転換の勝者はDC変換、保護、液冷電源ハードウェアのサプライヤーである。売上がMWあたりの低電圧AC銅やコンセント数に比例するサプライヤーは、総メガワットが増えてもAIホールでの成長は鈍化する。
系統側 1件の障害で3,900 MW
第2のコストは敷地の外にある。10月6日、PJMの信頼度エンジニアリングチームは計画委員会に対し、単一の系統擾乱の後にデータセンター負荷がバックアップ発電に切り替わった3件の事象を説明した。PJMの資料によれば、その規模は2024年7月10日が約1,500 MW、2025年2月17日が約1,800 MW、2026年7月22日が約3,900 MWであり、最後のものがこれまでで最大である。7月の事象では、まず約2,900 MWが移行し、1分後に約1,000 MWが続いた。東部連系系統の周波数は60.092 Hzに達した。
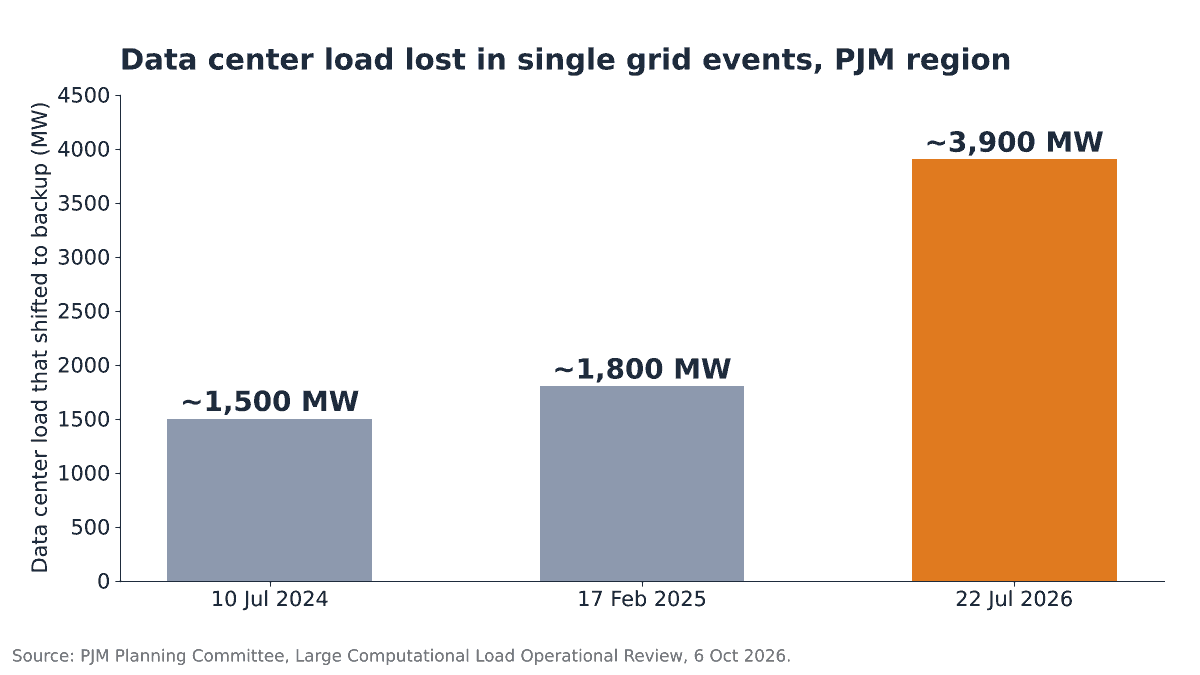
POWERの報道によれば、7月の負荷は当時のPJM需要の約3%であり、PJMは基幹電力系統への信頼度上の影響はなかったと報告した。2024年の調査は、こうした事象が起きる理由を示している。1.5 GWのすべてが需要家側の保護装置で遮断され、1分間に3回の電圧低下があった後に施設をバックアップに保持する仕組みにより、約1.26 GWが数時間にわたり停止したままであった。POWERは2026年7月の規模を3 GW超としているが、PJM自身のレビューでは約3,900 MWであり、本稿ではこちらを用いる。
これこそがGrid Resilience Specificationが解決しようとする問題である。NVIDIAのIan Buck(イアン・バック)氏はサミットで次のように位置付けた。
AIファクトリーは系統の一部となり、単なる消費者ではなく貢献者となる必要がある。
規則集 ライドスルーがコスト項目になる
規制当局はハードウェアと同じ時間軸で動いている。Utility Diveの報道によれば、NERCは2026年5月4日に演算負荷に関する異例のレベル3アラートを発出し、8月3日を回答期限とした。全負荷時と無負荷時、および10%以上の電圧変化時における試運転試験と、サイトへの故障記録装置の設置を求めている。
各事業者は概して、新たに出現した演算負荷に対処するための十分なプロセス、手順、手法を持っていなかった。
POWERの報道によれば、7月16日、FERCはNERCに対し、演算負荷に関する義務的な信頼度基準を提出するよう命じた。5人の委員全員がこの命令に賛成票を投じた。
NERCが提案したこのスケジュールは任意ではない。
| 規則または手続き | 要件 | 日付 |
|---|---|---|
| NERCレベル3アラート | 演算負荷のモデリングデータ、試運転試験、故障記録装置 | 2026年5月4日発出、回答期限2026年8月3日 |
| FERC命令、RD26-7-000 | 演算負荷に関するNERCの義務的基準 | 2026年7月16日命令、2026年12月31日提出期限 |
| PJMライドスルー草案(電圧) | ERCOTの電圧ライドスルーを最低基準とし、想定される擾乱の全期間に適用 | PJMのFERC申請は2026年11月を予定 |
| PJMライドスルー草案(復帰) | 障害後の電力を擾乱前の使用量の90%以上に回復 | PJMのFERC申請は2026年11月を予定 |
| PJM草案(既存サイト) | 技術的制約が文書化されない限り遵守が必要 | PJMのFERC申請は2026年11月を予定 |
| NERCフェーズII | 追加基準に関する情報提供申請 | 2027年3月1日 |
出典:PJM、2026年10月6日、POWER、2026年7月16日、Utility Dive、2026年5月5日。PJMの要件はLarge Load Working Groupによる草案であり、変更される可能性がある。
当社の見方では、既存サイトに関する条項が最もコストのかかる部分である。新設キャンパスであれば、UPS設定、保護方式、制御を当初からライドスルー基準に合わせて設計できる。北バージニアで稼働中のホールは、本来想定していなかった90%復帰ルールを満たすために、保護協調の検討、ファームウェアと制御の変更、場合によっては新たなハードウェアが必要になる可能性がある。
より広い潮流 建設コストは上昇を続ける
これらはすべて、すでに上昇しているコスト基盤の上にのしかかる。Turner & Townsendの最新のデータセンターコスト指数によれば、2025年の従来型データセンターの建設コストは52市場平均で5.5%上昇し、米国のAIデータセンターには同程度のIT容量を持つ従来型施設に対して7%から10%の建設プレミアムが生じている。最も高いのは東京でワットあたり15.2ドル、次いでシンガポールが14.5ドル、チューリッヒが14.2ドルであり、シリコンバレーは13.3ドルであった。当社試算では、シリコンバレーの単価で100 MWのホールを建設すると約13.3億ドルとなり、AIプレミアムにより約9,300万ドルから1億3,300万ドルが上乗せされる。
電力の確保は依然として重大な障壁であり、系統接続のリードタイムの長さが主な制約となっている。
標準設計は、この圧力に対する業界の回答である。Meta Engineeringの記事によれば、オハイオ州ニューアルバニーにある同社のPrometheusクラスターは2026年に約1 GWに達し、Hyperionは5 GWに向けて拡張中である。Data Center Frontierは、Prometheusの一部施設が簡素化された電源と冷却を用いて約3か月から5か月で稼働準備を整えたと報じた。当社の見方では、オープンな施設テンプレートは、コロケーション事業者にとって個々のラック仕様よりも価値が高い。複数のハイパースケールテナントが受け入れる1つのホールを建設できるからである。
運用事業者、投資家、ベンダーにとっての意味
上記の仕様と申請に基づく当社の見方は以下のとおりである。
- 初日がACであっても、新設ホールは今から800 VDCを前提に設計すべきである。サイドカー電源ラックのスペース、DCバスウェイの経路、DC保護は、設計段階であればほとんどコストがかからない。132 kWラック向けに建設したホールに後から改修で組み込めば、はるかに高くつく。
- 系統接続はメガワットではなく演算能力で評価すべきである。Enverusの数値に基づけば、同じ1 GWの接続でも800 VDCではITに約140 MW多く供給できる(当社試算)。この差はあらゆる電力購入とサイト評価のモデルに織り込むべきである。
- 既存サイトのライドスルー対応費用を予算化すべきである。PJMの草案は、技術的制約が文書化されない限り稼働中のホールにも適用される。北バージニアの容量を保有する事業者は、11月の申請前に保護協調とUPS設定の検討を開始すべきである。
- ベンダーは上流へ移る価値を追うべきである。MWあたりの搭載価値は、低電圧AC配電とコンセントから、ソリッドステート変換、DC保護、液冷バスバーへと移っている。
- ベンダーのコスト削減の主張は幅をもって捉えるべきである。NVIDIAの総所有コスト30%や保守コスト70%という数値は同社自身の主張である。Enverusの設備投資13%という推計の方が、計画上はより保守的な数値である。
- 銅は価格だけでなくスケジュールのリスクとして注視すべきである。LME銅が1トンあたり約14,650ドルで、2027年のプレミアムが過去最高となるなか、銅を45%から60%削減する設計は供給遅延への露出も減らす。
DC電力への移行に関する市場規模については、当社のData Center High-Voltage Direct Current (HVDC) Marketレポートを参照されたい。同レポートは2025年の市場規模を3億8,820万米ドルと評価し、2035年までに62億7,000万米ドルに達すると予測している。ラックレベルの電源ハードウェアについてはData Center Rack Power Distribution Unit Marketレポートを、天井配電についてはData Center Busway Marketレポートを参照されたい。系統接続と大規模負荷に関する規則は当社のUnited States data center power and policy trackerで、設置容量はUnited States data center capacityページで追跡している。
今後の注目点
- 2026年10月21日:NVIDIA GTC Berlinの基調講演。Vera Rubinと800 VDC導入に関する次のニュースの場となる。
- 2026年11月:PJMが大規模負荷のライドスルーに関する対応をFERCのドケットEL26-67-000に申請する目標時期。
- 2026年12月5日:演算負荷基準に関するNERC理事会の採決が見込まれる。
- 2026年12月:NERCのLarge Load Disturbance Performanceに関する報告書が見込まれる。
- 2026年12月31日:RD26-7-000に基づき、NERCの基準と手続規則の変更をFERCへ提出する期限。
- 2027年3月1日:NERCフェーズIIの情報提供申請の期限。
- 2027年:NVIDIAの2 MWロウ電源センターとKyberラックスケールシステムの登場。NVIDIAが800 VDCの本格量産を見込む時点である。
よくある質問
新しいオープンAIラック設計はどの程度の電力に対応するのか。
ラックあたり最大250 kWである。2026年10月12日のOCP Global Summitで公開されたNVIDIAのMGX 1.2仕様は、液冷式5,000 Aバスバーとファンレスの液冷コンピュートトレイを追加している。この密度では4ラックで1メガワットを消費する。
800 VDCは現行の電源設計と比べてどれだけ節約できるのか。
Enverusは、415 VACと比べて電気設備の設備投資が13%低く、効率が79.8%から93.8%に向上し、MWあたりの銅が最大60%少ないと推計している。NVIDIAは、ラック内54 Vシステムと比べて銅が45%少なく、保守コストが最大70%、総所有コストが最大30%低いと主張している。両者は基準が異なる。
データセンターはなぜ系統障害時に負荷を脱落させるのか。
電圧が低下すると、需要家側の保護装置がサイトをバックアップ電源に切り替えるためである。PJMでは2024年以降3回発生しており、最大の事象は2026年7月22日の約3,900 MWであった。NERCは、2024年の事象は電力会社の設備ではなく、すべて需要家側の保護装置によって引き起こされたと結論付けた。
新しいライドスルー規則はいつ適用されるのか。
NERCは、12月5日に見込まれる理事会の採決を経て、2026年12月31日までに義務的基準をFERCへ提出しなければならない。PJMは2026年11月に独自の申請を計画しており、その草案は技術的制約が文書化されない限り既存サイトにも適用される。
出典
- NVIDIA、”OCP Global Summit: Amid Ecosystem Adoption, NVIDIA Opens Vera Rubin Architecture to Help Scale AI Factories Worldwide”、2026年10月12日。リンク
- PJM計画委員会、”Large Computational Load (LCL) Operational Review”、2026年10月6日。リンク
- NVIDIA、”Why Scaling AI Compute Performance Requires a New Power Architecture”、2026年8月11日。リンク
- NVIDIA Technical Blog、”NVIDIA 800 VDC Architecture Will Power the Next Generation of AI Factories”、2025年5月20日。リンク
- Enverus、”800 VDC rewrites AI data center power economics”、2026年6月24日。リンク
- Vertiv、”OCP Global Summit 2026″、2026年10月。リンク
- Meta Engineering、”OCP Summit 2026: Powering AI with Open Innovations in Scale-Up, Scale-Out, and Scale-Across Networks”、2026年10月12日。リンク
- Turner & Townsend、”AI data center rush raises alarm over construction supply chain”、2025年11月5日。リンク
- POWER magazine、”FERC Orders Mandatory NERC Reliability Standards for Data Center and Other Computational Loads”、2026年7月16日。リンク
- POWER magazine、”3 GW Off PJM, Again: What NERC’s 2024 Investigation Already Told Us”、2026年8月10日。リンク
- Utility Dive、”NERC issues Level 3 alert, mandates action to address data center load losses”、2026年5月5日。リンク
- Data Center Frontier、”OCP 2026: Agentic AI Drives the Data Center’s Chip-to-Grid Transformation”、2026年10月13日。リンク
- Reuters via Kitco News、”Aurubis raises 2027 European copper premium to record $347 a ton, sources say”、2026年10月14日。リンク
- Yahoo Finance、”Nvidia, AMD, Google, and Meta team up on global blueprint for data center design”、2026年10月12日。リンク
- HPCwire、”NVIDIA Details Open Designs for AI Power, Cooling and Networking”、2026年10月13日。リンク